当虹科技董事长孙彦龙合著论文在AI顶会NeurIPS发表
本文希望呈现的,是一条当虹科技正在往前探索的技术脉络:从超高清视频编解码出发,穿过空间计算,抵达「生成即感知」的范式创新——以及它的下一站:物理 AI 与 RSI(递归自我改进)。
01一次战略升级:双引擎,指向同一个方向
面向新的视觉任务和场景,模型可以复用已有视觉知识,通过少量数据进行针对性适配,而不必为每项任务都从头训练模型。比如在特定新任务的实验中,DiCeption仅使用50张训练图像、微调不到1%的模型参数,便实现了有效适配。
回顾一年前,2025 年 9 月 19 日,当虹科技企业战略重大升级暨 BlackEye 2.0 多模态空间大模型新品发布会上,当虹科技宣布:公司战略从「以视频为核心」,正式迈向以「AI 多模态 + 空间视频 + 行业」为核心的全新发展阶段。董事长孙彦龙对此的判断十分明确:当前正处于空间计算加速演进的前夜,当虹科技将致力于空间世界的表达、感知、压缩、传输、重建和交互。
在许多人看来,这是一次转型的宣言;但将其置于当虹近三十年的技术脉络中,它更像一次「显影」——过去近三十年,当虹科技始终在做同一件事:把体量巨大的空间信息,在受限的信道里,又快又好地送达需要它的人。变化的是对象——从演播室里的超高清信号,到弱网链路下的机器狗,再到三维点云与空间场景;不变的是主线:表达、压缩、传输、感知、交互。
作为战略的「双引擎」,BlackEye 2.0 多模态空间大模型支持文本、图像、视频、音频、点云五类模态的处理,在视频增强、压缩与 AIGC 能力上显著提升,尤其在空间感知、场景重构与空间复刻等空间视频领域取得突破,并已通过国家网信办算法和大模型「双备案」。AI 多模态与空间视频,并非两个独立运转的引擎,而是同一套空间信息处理管线的两个侧面:一个负责「看得懂」,一个负责「传得出、建得真」。
随之而来的核心问题是:机器,究竟要如何「看得懂」世界?
02感知的鸿沟:机器人如何「看懂」世界
将视线投向近两年的机器人行业:人形机器人与四足机器人快速迭代,但从「会走路」到「能干活」之间,横亘着一道感知鸿沟——机器狗必须知道哪里是可通行区域、被困人员在哪里、火源在哪里、坍塌风险在哪里,才可能替人进入人类无法抵达的环境。
传统方案是「一个任务,一个专属模型」:分割交给 SAM(由 11 亿级掩码标注训练而来),深度估计交给 Marigold,法线估计交给 GeoWizard,关键点检测交给 ViTPose。每接入一个新任务,机器人身上就叠加一层模型,算力负荷持续增加、时延层层累积,部署日趋臃肿。更关键的是,场景稍有变化——更换厂房、更换灾情类型——就需要重新标注数据、全量重训模型,周期以月计、成本以百万计。
对「远程作业、现场多变」的具身智能场景而言,这条路径难以走通。机器人需要的不是一柜子专属模型,而是一双通用的、能够快速学习新任务的「眼睛」。
03「生成即感知」:一篇 NeurIPS 论文的回答
2025 年,由当虹科技董事长孙彦龙与浙江大学、清华大学、上海人工智能实验室等机构组成的联合团队完成的论文《DiCeption: A Generalist Diffusion Model for Visual Perceptual Tasks》,发表于国际顶级学术会议 NeurIPS 2025(CCF-A 类,Spotlight)。这篇论文给出的答案,是四个字的范式创新:生成即感知。
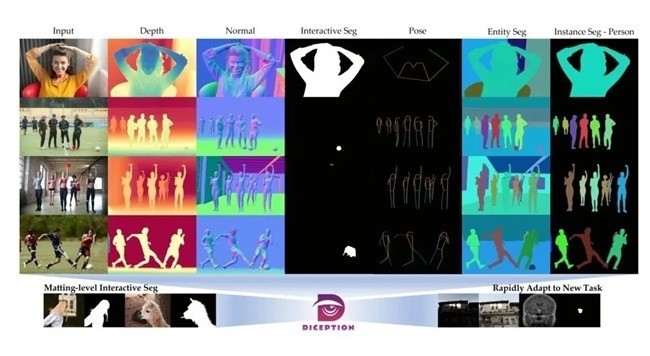
DiCeption 以单一模型同时完成深度、法线、交互式分割、姿态、实体分割、实例分割六类任务
(图源:NeurIPS 2025 论文)
其核心思想在于:生成式大模型在数十亿图像与视频上训练,所习得的不只是「如何生成」,更是对物理世界结构的深层先验——光影如何落在物体表面、几何如何构成、遮挡如何发生。与其从零训练一个感知模型,不如将这份「世界先验」迁移给感知任务:把每类感知任务的输入与输出统一映射到图像空间,感知任务即转化为「条件图像生成」——输入一张图像与一句任务提示,模型「生成」出深度图、分割掩码或人体骨架。
支撑这一范式的,是三个关键设计。其一,RGB 统一表征空间:所有任务的输入输出统一编码至 RGB 空间,最大化复用扩散模型的图像先验;其二,Token 序列拼接机制:输入图与噪声图的 Token 拼接进入全参数共享的 DiT 主干,多任务统一训练,无需任何任务专用模块;其三,冻结编码器与流匹配训练:最大限度保留预训练先验不被破坏。
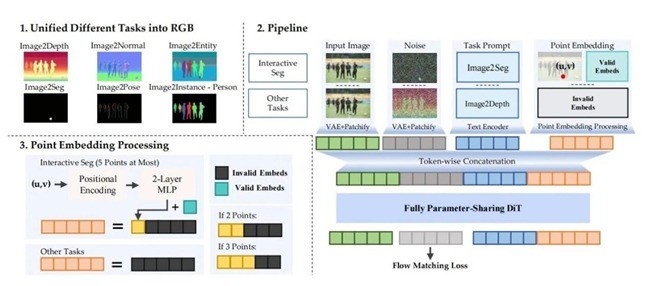
DiCeption 通用感知架构:RGB 统一表征、Token 拼接、冻结编码器 + 流匹配训练
(图源:NeurIPS 2025 论文)
效果可以落到三个数字上:单一模型完成深度估计、法线估计、交互式分割、姿态估计、实体分割、实例分割等六类视觉感知任务;以分割为例,性能与训练了 11 亿掩码的 SAM-vit-h 相当,而训练数据仅为其 0.06%(60 万对 11 亿);适配一个新任务,仅需约 50 张图片、微调约 1% 的参数。
对机器人行业而言,这三个数字分别对应三个现实难题:单一模型多任务,意味着部署形态从「一柜子模型」收敛为「一块芯片」;0.06% 的数据需求,意味着冷启动成本下降数个数量级;约 50 张图适配新任务,意味着机器人抵达新现场后可以「现场学习」。
04从论文到产品:BlackEye Vision 的「三域五层」
将论文范式转化为矿场、火场与高危作业现场可用的工程系统,中间隔着三座山:传得动、看得清、控得稳。当虹的回答,是将 DiCeption 通用感知范式应用于BlackEye Vision 机器人超远距离远程遥操作系统,形成「三域五层」的完整架构:端侧机器人负责多模态传感与智能压缩编码,传输网络以 5G/4G/WiFi/专网实现低延时鲁棒传输,远端操控中心完成解码重建、多模态融合感知与三维交互渲染。
在标准化操控任务的实测中,从局域网、5G、4G 到卫星链路,BlackEye Vision 端到端延时稳定保持在百毫秒以内,演示环境可达 80 毫秒以内——操作体验接近「如临现场」。在地震、火灾等极端场景下,系统可自动切换卫星互联网链路,操控与回传不中断。
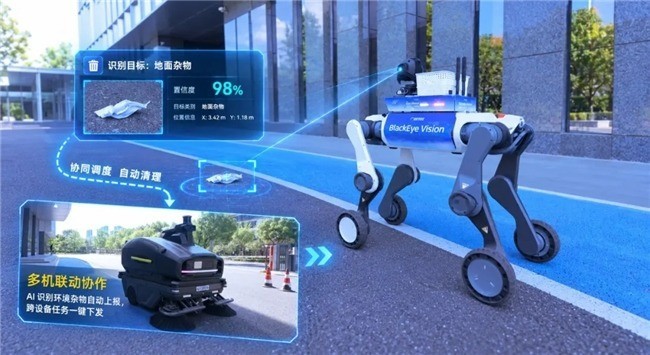
(当虹多模态感知上装件识别异常并通过巡检平台协同处置)
这套系统已在真实环境中形成了可验证的落地足迹:150 公里外的高危区域,机器狗替代人员先行进入巡防;1300 公里外的杭州,实现机器狗视角跨省实时直播「云赏西湖」;1700 公里外的乌兰哈达火山,操作员通过一部手机完成气体采样与影像回传。依托 BlackEye Vision,当虹科技已与十余家头部机器人企业建立合作,将系统带入消防救援、化工巡检、应急抢险、库区巡检等高风险场景——从职业赛场上的机器人摄像师,到重点库区自主巡检的防爆机器狗。
05下一步:构建机器人的自进化闭环
如果说以上是「现在进行时」,真正值得关注的,是正在构建的下一步。
远程遥操作系统天然是一台「数据发动机」:每一次远程作业,都在客户授权与数据安全框架下产生物理世界的第一手作业数据——画面、点云、指令与执行结果。过去,这些数据沉淀为模型能力,依赖昂贵的标注与全量重训;而当 DiCeption 将这一门槛降至「约 50 张图、约 1% 参数」,模型迭代便从「项目制」走向「日常态」。
由此,一个自进化闭环正在成形:机器人在真实场景作业 → 系统在数据合规框架下沉淀作业经验 → 通用感知模型以少量数据快速适配新任务、新场景 → 更强的感知能力支撑机器人进入更远、更复杂的现场 → 产生更有价值的数据与经验。能力随作业时长持续增长。
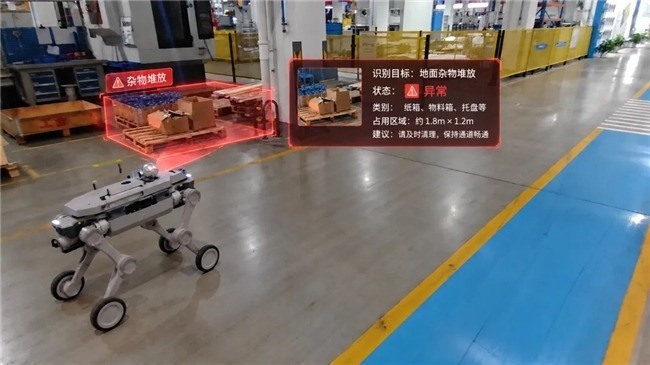
(搭载当虹多模态感知上装件的四足机器人正在巡检)
这就是当虹正在研发的机器人版 RSI(Recursive Self-Improvement,递归自我改进)——AI 系统在运行中持续产生改进自身所需的数据与反馈,实现能力的自我迭代。当虹的路径,不是等待一个「超级模型」从天而降,而是把「感知模型可以快速进化」做成远程遥操作系统的内生能力:在客户数据不出域的前提下,让每一台在真实场景作业的机器人,都成为模型进化体系的一部分。
06下一站:物理 AI
回望这条技术线,每一步都不是另起炉灶:视频压缩让画面「传得动」,点云压缩让场景「看得清」,「生成即感知」让机器「看得懂」,BlackEye Vision 让人机「控得稳」,而智能体与数据闭环正在让系统「学得会」。它们是同一条主线上的相邻站点:对空间信息更高效的表达、感知、压缩、传输、重建与交互。
这条线的下一站,是物理 AI(Physical AI)——让智能体在真实物理世界中感知、决策、行动,并随部署持续增强。当机器人拥有可进化的感知底座与持续回流的真实作业经验,物理世界本身,就成为它最大的训练场。
具身智能与物理 AI 快速升级,当虹科技已经在路上。我们相信,未来最好的机器人,不是被编程出来的,而是被真实世界「教会」的。这条从视频通往物理 AI 的技术远征,期待更多同行者。
文章来源:当虹科技「生成即感知」的技术远征https://news.zol.com.cn/1265/12657814.html